主標:從「賣產品」到「賣智能」——算力(Token)出海:被低估的數字貿易新賽道
副標:算力即外匯:綠電、基建與大模型構成的出海新三角

文/王錦彪(中國僑聯顧問、香港僑界社團聯會主席、香港國際網絡電視台聯席主席)
很多人還沒反應過來——現在的中國,增長最快的「出口生意」既不是新能源,也不是光伏、電動車,而是算力。
這絕對是今年最被低估、未來十年卻最能賺錢的超級風口。
一、數據說話:東方算力正在接管全球
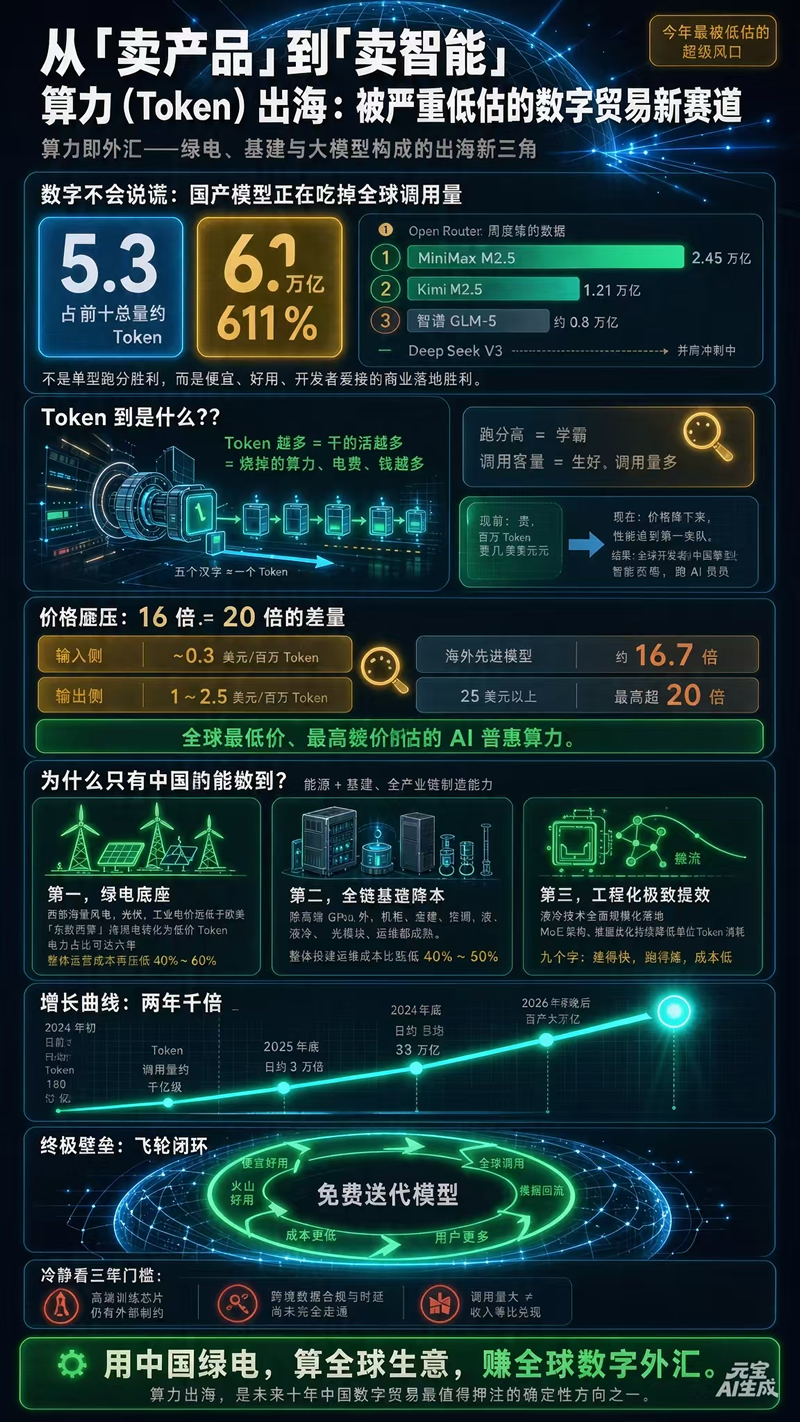
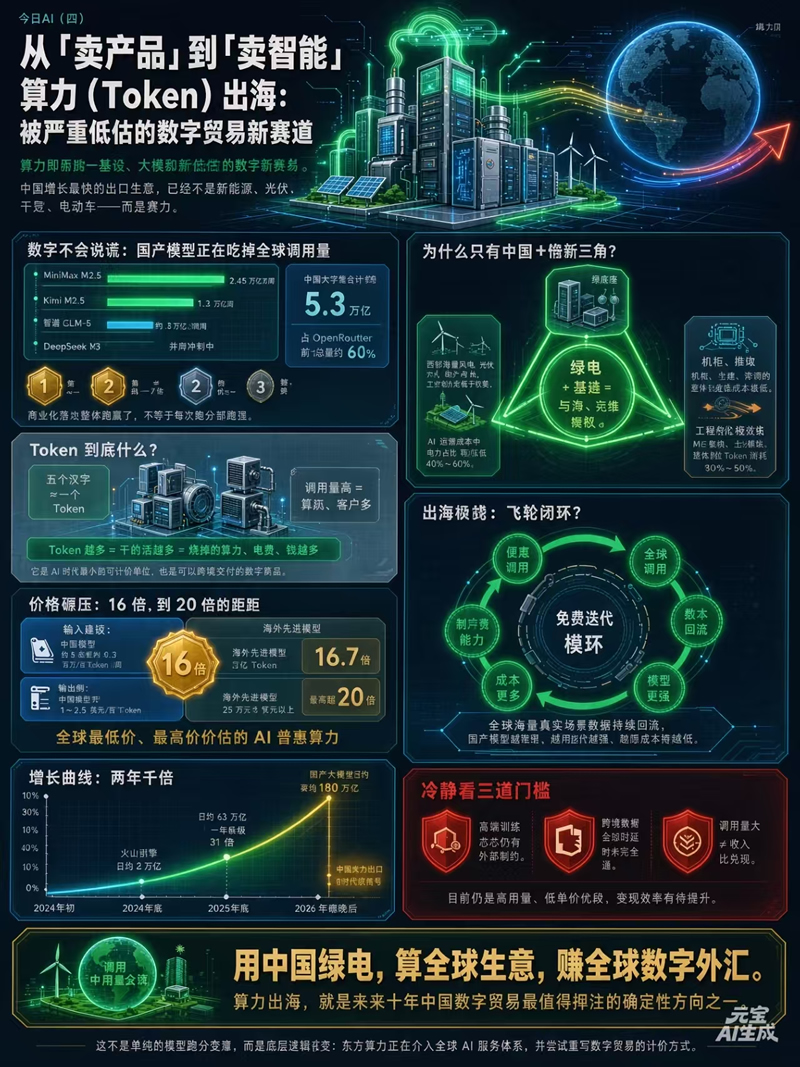
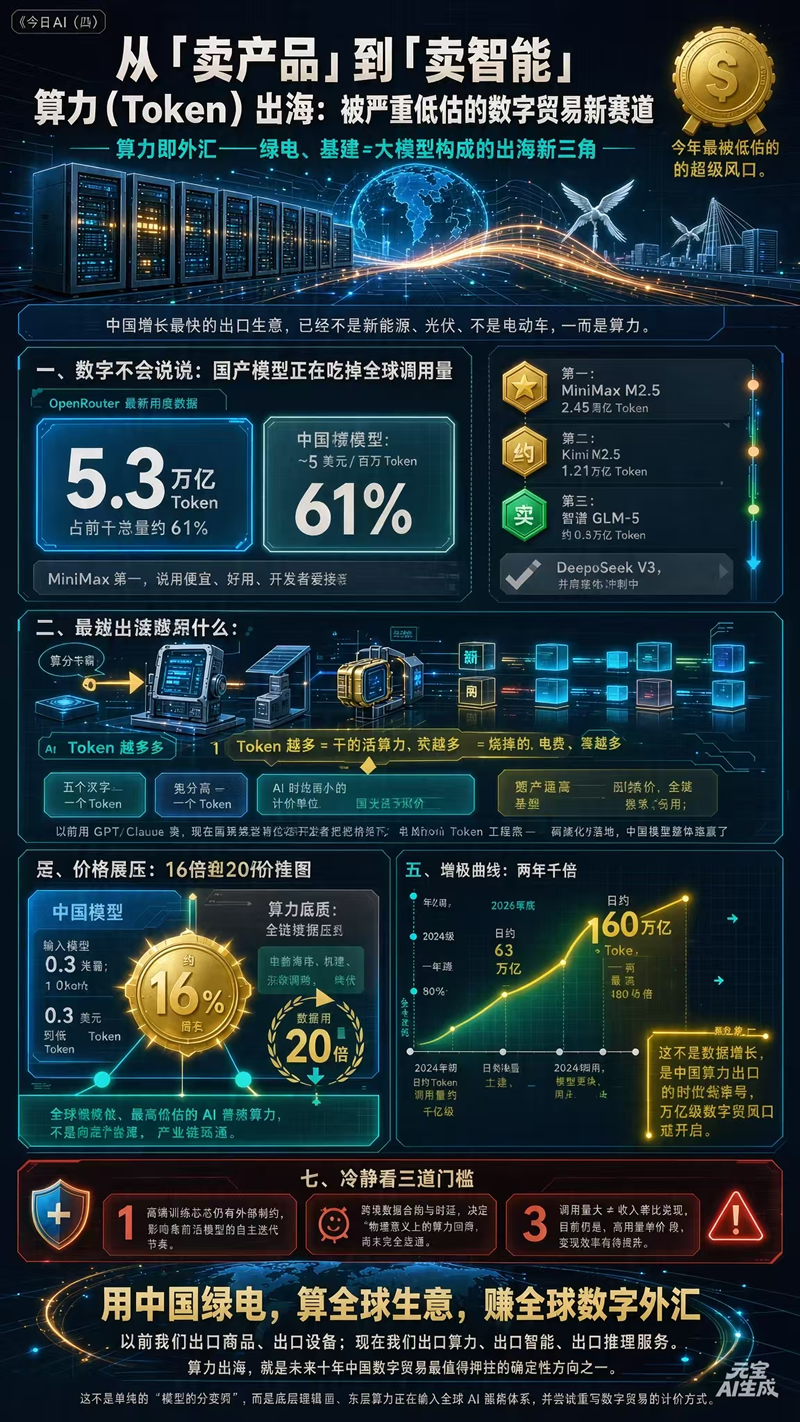
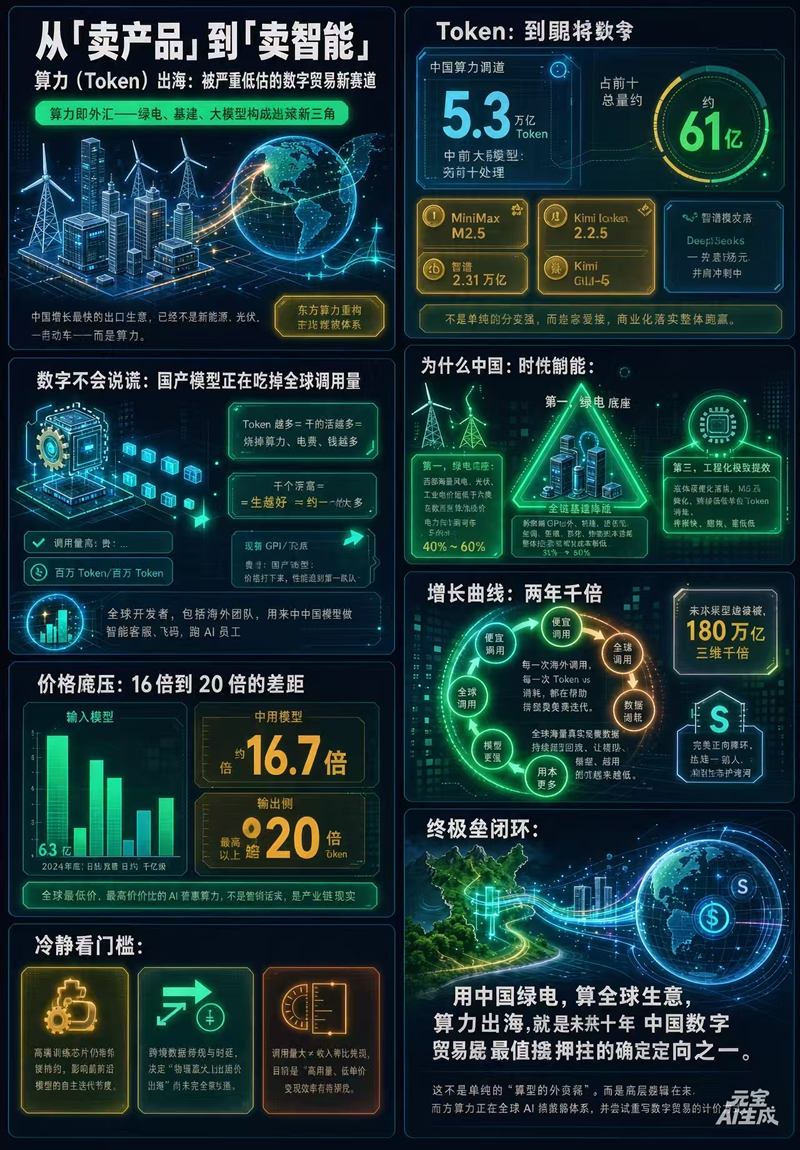
OpenRouter 最新週度數據顯示,平台前十模型中有七款中國大模型,合計處理 5.3 萬億 Token,佔前十總量的 61%。
榜單前三被中國模型包攬:
MiniMax M2.5:單週 2.45 萬億 Token,斷層領先
Kimi K2.5:單週 1.21 萬億 Token,穩定緊隨
智譜 GLM-5:約 0.8 萬億 Token,與 DeepSeek V3 並肩衝刺
千萬別以為這祗是「國產模型跑分變強」這麼簡單。看懂背後的底層邏輯,你才看懂未來十年的超級財富賽道——這是東方算力正在重構全球 AI 服務體系,改寫數字貿易的計價規則。
二、Token 是什麼?為什麼它是「數字外匯」?
把 AI 想成一間「文字工廠」:
Token 越多 = 幹的活越多 = 燒掉的算力、電費、錢越多
跑分高 = 學霸(理論強)
調用量高 = 生意好、客戶多(商業強)
五個漢字約等於一個 Token。它是 AI 時代最小的可計價單位,也是一種可以跨境交付、實打實變現的數字商品——本質上就是 AI 時代的「工時」。
以前用 GPT / Claude,貴得離譜:百萬 Token 輸入要幾美元,輸出更貴 5 倍。重度用戶跑 Agent 任務,月費輕鬆飆到幾千美元。
現在,中國模型把價格打到地板,性能卻追進第一梯隊。結果就是——全球開發者(包括大量海外用戶)蜂擁而來,用中國模型做智能客服、寫代碼、跑 AI 員工。
三、成本碾壓:16 倍到 20 倍的價差鴻溝
中國算力的核心競爭力祗有兩個字:成本。
中國模型海外先進模型價差輸入側(美元/百萬Token)~0.3~5約 16.7 倍輸出側(美元/百萬Token)1~2.525+極端超 20 倍
我們擁有的是全球最低價、最高性價比的 AI 普惠算力。這不是偶然,是硬核底氣。
四、為什麼祗有中國能做到?三大支柱
算力的本質從來不祗是芯片,而是「能源 + 基建 + 製造鏈」的系統工程。這三樣,祗有中國做到了全球極致:
第一,綠電底座。 西部海量風電、光伏讓工業電價遠低於歐美。疊加專項算力補貼,整體運營成本再壓低 40%~60%。AI 運營成本中電力佔比可達六成,中國電價優勢被規模推理進一步放大。
第二,全鏈基建。 除高端 GPU 外,從液冷、光模塊、服務器到數據中心運維,中國具備完整供應鏈。整體投建與運維成本比歐美低 30%~50%。
第三,工程化提效。 液冷技術全面規模化落地、MoE 架構(混合專家模型)普及、推理持續優化,單位 Token 的算力消耗不斷下降。總結九個字:「建得快、跑得穩、成本低。」
註:用最好倍數的放大鏡看圖片、文字會較清晰。
五、增長曲線:肉眼可見的指數爆發
2024 年初:中國日均 Token 調用量約 千億級
2024 年底:火山引擎日均僅 2 萬億
2025 年底:直接衝到日均 63 萬億(一年暴漲 31 倍)
2026 年春節後:國產大模型日均 Token 處理量突破 180 萬億
兩年間增長超千倍。這已經不是數據增長,這是中國算力出口的時代級信號——萬億級數字外貿風口正式開啟。
六、飛輪效應:終極壁壘是生態閉環
為什麼全球用戶都在用中國算力?因為便宜、穩定、好用,用腳投票。
而每一次海外調用、每一次 Token 消耗,都在幫我們免費迭代模型——全球海量真實場景數據持續回流,讓國產模型越用越準、越用越強、邊際成本越來越低。
便宜好用 → 全球開發者湧入 → 真實數據回流 → 模型更準成本更低 → 用戶更多 → 數據再翻倍
這個完美的正向飛輪,直接築起別人永遠突破不了的生態護城河。這才是真正的「終極壁壘」。
註:用最好倍數的放大鏡看圖片、文字會較清晰。
七、冷靜看三道門檻
i) 高端訓練芯片仍有外部制約,自主替代還在路上
ii) 跨境數據合規與時延限制——物理意義上的「算力出海」還沒完全走通
iii) 調用量 ≠ 收入等比兌現,目前仍是「高用量、低單價」階段.調用量高不代表模型絕對最強,祗是說明商業化落地跑贏了。這一點必須冷靜看待。
八、結語:新規則,新風口
以前我們出口商品、出口設備;現在,我們出口算力、出口智能、出口推理服務。
新規則:用中國綠電,算全球生意,賺全球數字外匯。
算力出海,就是未來十年中國數字貿易最值得押注的確定性方向之一。
小词典
1)ChatGPT
定义:由OpenAI于2022年11月发布的对话式AI产品,基于GPT-3.5系列模型打造,标志着人工智能进入大模型时代。
技术阶段:属于生成式人工智能(AIGC)。不同于传统判别式模型(仅做分类识别),它能自主生成文本、代码等新内容,核心架构为Transformer。
关键训练技术:RLHF(人类反馈强化学习):将人类主观判断作为奖励信号,引导AI按人类期望对齐。ChatGPT香港RLHF,从“会接话”进化到“好用、安全”,大幅减少胡言乱语和有害输出,是其能大规模落地的关键一环。
2)Claude
定义:由Anthropic公司开发的AI助手与大语言模型。公司由前OpenAI成员创立,主打“安全、诚实、有用”,以“信息论之父”克劳德·香农(Claude Shannon)命名。
核心优势:
超长上下文:支持最高100万Token上下文,可一次性处理《三体》三部曲体量的文本或整套代码库,长文档分析能力极强。
低幻觉、更严谨:不确定时会直接承认“不知道”,极少编造信息,适合法律、金融、科研等高要求场景。
3)飞轮效应
定义:静止的飞轮启动时需持续施力,动能累积到临界点后,外力需求减少,系统进入自主高效运转的状态。
隐喻:起步阶段往往能耗高、痛苦强,需持续投入;一旦突破临界点形成惯性,行动能耗便会大幅下降,进入自动运转的良性循环。
4)“终极壁垒”
定义:竞争对手难以绕开、复制或夺走的深层护城河。它并非单一技术,而是一整套自我强化的循环机制,能让“你的系统越用越强,对手越难追赶”。
香港国际网络电视台/2026.11.10